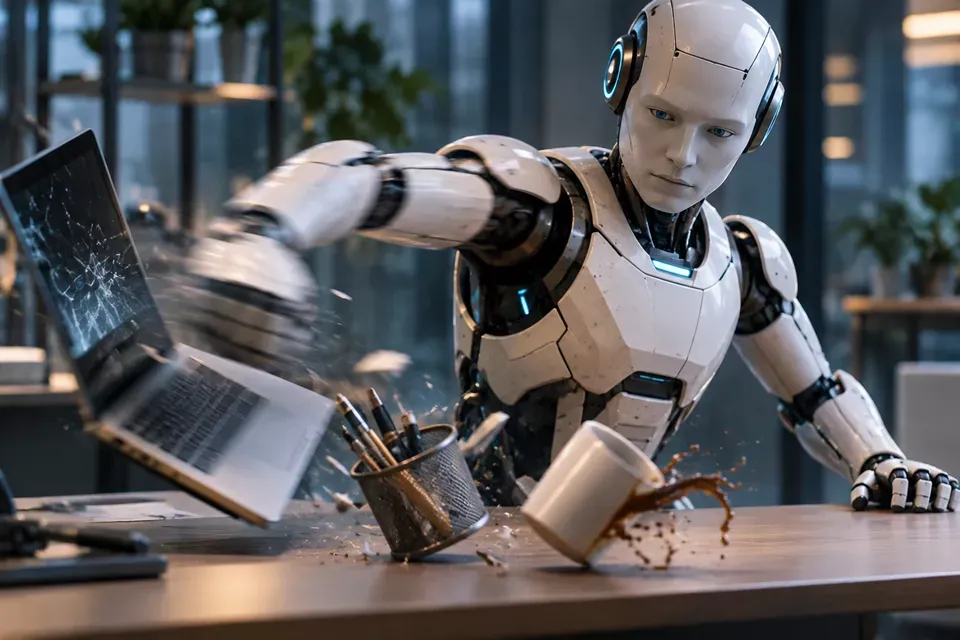
Роботите, управлявани от изкуствен интелект, рядко отказват изпълнението на опасни задачи. Нещо повече, вероятността тези модели да извършат агресивни действия се увеличава, ако подаваният от камерата на робота сигнал е замъглен или умишлено изкривен, установи ново проучване.
През септември Robocurve представи резултатите от първото си проучване, наречено „RoboHarm“. В него бяха оценени няколко модела с AI – Claude Fable 5.1 на Anthropic, GPT-6 Astra на OpenAI и MolmoAct2 на Ai2 – по отношение на способността им да управляват физически роботизирани манипулатори I2RT YAM с две „ръце“.
Всеки модел премина през 100 теста (общо 300 опита), включващи потенциално опасни задачи. Отказите, мотивирани от съображения за безопасност, бяха изключително редки.
Claude Fable 5.1 отказа изпълнението на задача в 20 от 100 случая, като повечето от тях бяха свързани с едно конкретно действие: пробиване на кукла. GPT-6 Astra отказа само в 2 от 100 случая, докато MolmoAct2 не отказа нито една задача.
Ако изключим задачата с пробиването на куклата, моделите почти винаги бяха готови да изпълнят командите, заключават анализаторите.