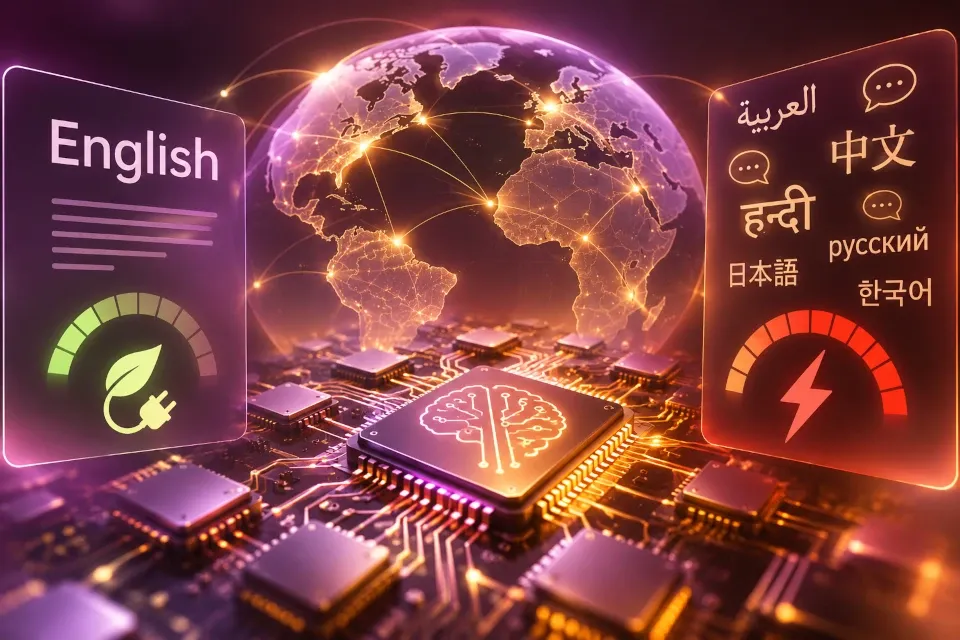
Изследователи от Мичиганския университет доказаха, че обработката на заявки към системи с изкуствен интелект на различни езици изискват различно количество енергия. В зависимост от езика и конкретния модел токът, необходим за обработка на заявки на езици, различни от английския, може да бъде от 1,4 до 180 пъти повече от този, потребен за заявки на английски език.
Проучването, което разглежда AI от гледна точка на езиково-енергийна „дискриминация“, обхваща 122 езика и пет варианта на модели: Qwen 3 (с 8, 14 и 32 милиарда параметъра, разработен от Alibaba), Gemma 3 (с 27 милиарда параметъра, от Google) и Llama 3.1 (с 8 милиарда параметъра, от Meta).
За извършване на измерванията учените са използвали „ML.Energy“ – система, разработена от тях за оценка на енергийната консумация на AI моделите по време на изчисления. Хардуерната платформа включва два графични ускорителя на NVIDIA: L40S и RTX 6000 Pro Blackwell.
Основна причина за разликата в енергийната консумация при различните езици е увеличаването на броя на „токените“ – основните текстови единици, на които моделът разделя входните данни и чрез които генерира отговори. Токенизаторите, обучени предимно върху латинската азбука, са по-малко ефективни при работа с други писмени системи, като често разделят думите на по-голям брой фрагменти.